Оригинал: What Comes After Observability?
Что будет после наблюдаемости?
20 июля 2026
Год назад я строил догадки о том, как ИИ должен был радикально изменить привычную нам наблюдаемость. Пришло время посмотреть, что из этого вышло на самом деле — как у нас в Honeycomb, так и у наших клиентов, — а заодно рассказать, что мы сейчас готовим на будущее.
Год назад я написал пост «Это конец наблюдаемости (и я спокоен)». Суть была в том, что ИИ кардинально поменяет то, как мы проектируем и эксплуатируем системы. Сейчас, по доброй традиции, я хочу пересмотреть свои тогдашние заявления и проверить, насколько я оказался прав.
Тезис первый: агенты проводят расследования с нуля меньше чем за доллар
Я задал агенту тот же вопрос, который мы обычно задаём на демо-встречах. Агент справился сам, без дополнительных подсказок, дообучения и инструкций… и уложился в 60 центов.
В прошлом посте я рассказывал, как проверял наш MCP-сервер: скормил ему запрос, похожий на тот, что мы даём людям на демо — мол, вот странный всплеск задержки, разберись и скажи, в чём дело. Тогда у него ушло восемь вызовов инструментов и примерно $0,60 на «подумать». А сейчас, через год, мы обрабатываем около 2 миллионов запросов в месяц, которые инициируют именно агенты!
Однако по-настоящему любопытно другое: мы заметили, что агенты начали справляться с задачами, требующими гораздо большего числа шагов и более длинного горизонта планирования. Современные передовые модели — например, Sonnet или Fable 5 — становятся всё более самостоятельными («агентными») и способными. За один сеанс работы агента среднее количество вызовов инструментов удвоилось в период с февраля по июнь этого года. Наше первоначальное демо с восемью запросами выглядит теперь просто забавным и очень скромным.
Тезис второй: человек остаётся в контуре управления
При этом я не собираюсь сидеть здесь и заявлять, что это убивает необходимость участия людей. Я так не считаю. Появление облаков не уничтожило профессию IT-специалиста. Появление Rails не оставило без работы серверных программистов. Рост производительности не сжимает рынок, а расширяет его. Будет появляться всё больше программного обеспечения, самого разного, под любые задачи. Нам потребуется больше всего — и людей, и инструментов.
И вот что по-настоящему интересно: количество запросов, инициируемых людьми, ничуть не уменьшилось. Агенты не забирают расследования у людей, они лишь дополняют их и делают их круче. Люди всё так же заходят в интерфейс, смотрят свои дашборды, но теперь они могут сделать гораздо больше благодаря ИИ. Особенно хорошо это видно на примере правок: люди активно используют агентов, чтобы собирать дашборды и обновлять SLO, однако подавляющее большинство вызовов инструментов по-прежнему приходится просто на выполнение запросов.
В прошлом посте я говорил, что рост производительности не приведёт к обесцениванию роли человека, — и данные это полностью подтверждают. Карта — это не территория, но с приходом агентов она стала значительно больше и детальнее.
Правда, не стоит думать, что все эти агенты управляются человеком напрямую. Мы наблюдаем устойчивый рост количества «безголовых» агентов (headless agents), использующих наш MCP. На самом деле это самый быстрорастущий сегмент.
Тезис третий: с каждым днём это дешевле
Затраты на логический вывод (inference) неуклонно снижаются… Если ключевая ценность вашего продукта — красивые графики и простота инструментирования, то вы, считайте, покойник. LLM превращают анализ данных в обычный товар, а OpenTelemetry делает то же самое с инструментированием.
В прошлый раз я сделал ставку на то, что стоимость вывода будет падать. В целом это так и есть (хотя многие хватаются за голову, когда переходят с безлимитных тарифов на оплату по API для рабочих задач). Но, например, этот пост я пишу на ноутбуке, где спокойно работает локальная модель Gemma4 от Google, и она отлично справляется с нашим MCP. Я уверен, что в долгосрочной перспективе стоимость ИИ будет только снижаться при том же уровне возможностей.
Но чего я совершенно не учёл год назад, так это того, что роботы на удивление экономно расходуют ресурсы самого Honeycomb! В среднем запрос, сделанный агентом, обходится нам примерно вдвое дешевле, чем аналогичный запрос от человека. Объясняется это довольно просто: агенты способны гораздо точнее понять, что именно нужно искать, особенно если им дать доступ к вашему коду. Они сразу знают, на что смотреть, и не тратят время и ресурсы на хаотичный поиск по всей системе, пытаясь сориентироваться на местности.
Ещё мы заметили, что агенты в среднем выполняют запросы за временной промежуток, который на 50% короче того, чем делают люди. Но самое любопытное — как по-разному ведут себя те или иные агенты. Самописные пользовательские (кастомные) агенты обычно смотрят на узкие временные окна, а те, что под управлением человека, охватывают более длинные периоды. Моё предположение: самописные агенты больше заточены на конкретную задачу («вот ошибка, поищи трассировки в этом промежутке времени»), а то, что делают люди, — это скорее исследование и разработка.
Но самый главный, самый яркий показатель: в среднем один запрос от агента «разворачивается» на 3,3 раза меньше лямбда-функций, сканирует в 1,8 раза меньше байтов и жрёт в 2,2 раза меньше вычислительных мощностей, чем запрос человека. Что это дало нам на практике? С марта по июнь мы выросли по числу запросов в 4 раза, а наши расходы увеличились всего на 23%! Удельная стоимость запросов от агентов снизилась на 72%. Я такое обожаю.
Средние показатели за июнь 2026 года на один запрос:
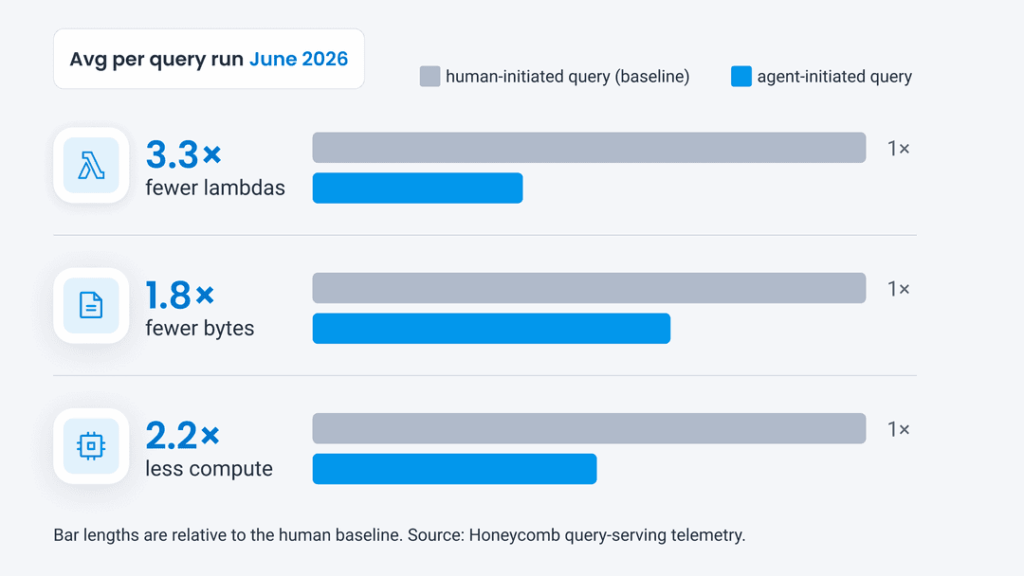
- Лямбд уходит в 3.3 раза меньше
- Байт сканируется в 1.8 раза меньше
- Вычислительных ресурсов тратится в 2.2 раза меньше
- (Относительно обычного человеческого запроса)
Правда, есть и ложка дёгтя: агенты ужасно работают с кешированием. Для интерактивных запросов людей кеширование и так не особо работает, а для агентов — вообще практически никак. Они просто не задают один и тот же вопрос дважды. Я также заметил, что агенты с большей охотой перезапускают запросы заново, чем переиспользуют уже существующие результаты. Это интересный момент, возможно, стоит изучить отдельно.
Но, несмотря на это, внедрение растёт бешеными темпами, особенно в крупных компаниях. Один наш крупный клиент за месяц вычитал 62 PiB данных исключительно через агентов, используя готовые инструменты вроде Claude Code.
Впрочем, есть и обратная сторона: многие такие запросы выполняются довольно медленно, потому что агенты копаются не в аккуратно структурированных данных, а пытаются искать (grep-ать) по сырым, неструктурированным полям. И теперь структурированные, высококардинальные и многомерные данные — это уже не приятный бонус для людей, а жёсткое требование, чтобы расследования агентов не разорили вас. Вся та масса данных, которую агент перелопачивает в поисках иголки в стоге сена, — это ваши токены, за которые вы платите. Хотите платить по тарифам Fable за то, чтобы просматривать гигабайты мусорных логов?
Тезис четветый: быстрые циклы обратной связи — это всё
Я поставлю на этом точку: единственное, что реально имеет значение, — это быстрые и плотные циклы обратной связи на всех этапах: от разработки до эксплуатации. ИИ любит скорость — он всегда будет быстрее вас.
Просто попросите Claude резюмировать, что сейчас говорят про эти «циклы», и вы увидите, что всё остальное ИИ-сообщество обсуждает именно то, о чём я написал здесь год назад.
В общем, первенство мне не светит, но лучше я расскажу историю одного из наших клиентов. Пишет нам чувак и взахлёб рассказывает, как он любит MCP и как использует. Он подключил к агентам всё, что можно, и они стучатся в Honeycomb. Когда клиент жалуется на проблему или кто-то заводит баг, агент лезет в продакшн-телеметрию — проверить. Когда SLO горит, агент лезет смотреть. Агент проводит расследование, передаёт другому агенту, тот пишет исправление и создаёт пул-реквест. Третий агент проверяет этот PR и зовёт человека — просто для финальной проверки и влития. PR уезжает в прод, просыпается первый агент, смотрит телеметрию, чтобы убедиться, что проблема решена. Если нет — цикл повторяется.
Да, мы в Honeycomb прямо сейчас строим именно такой инструмент. Но то, что мы готовим на завтра, — намного круче. Я не хочу, чтобы мы просто сделали очень быструю колоночную базу (хотя это, безусловно, прикольно). Я хочу, чтобы у каждого была возможность легко создавать такие быстрые циклы обратной связи. Чтобы вы могли видеть, что ваши агенты вытворяют с вашим кодом, и чтобы и вам, и вашим агентам было просто учиться на продакшн-данных и превращать эти знания в реальную пользу.
Если вы уже видели Canvas и нашего Canvas-агента — вы видели первый набросок этой идеи (а если нет, зацените — это бесплатно!). Но это только первая глава.
P.S. Кстати, мы ищем людей. Если хотите делать агентов — приходите к нам.