Reliability Block Diagrams (RBD, блок-схема или структурная схема надежности) — это один из методов анализа надежности системы, существует уже очень давно, помогая системным инженерам понять, как различные элементы и их взаимосвязи могут повлиять на общую надежность и работу системы. Построив логическую схему системы, можно получить отличное представление о том, где находятся ее слабые звенья. В некоторых случаях RBD может показать, что предусмотренная вами избыточность некоторых компонентов на самом деле не так эффективна, как вы думаете. Система, если рассматривать ее логически и физически, может выглядеть совершенно по-разному.
Метод анализа RBD применяют на стадии разработки концепции. Разработка RBD должна начинаться как часть анализа требований, и непрерывно расширяться до более глубокого уровня детализации по мере увеличения данных для принятия решений.
Построение RDB эффективно и полезно для моделирования сложных систем, таких, например, как:
систем с резервированием функций,
систем с внутренними функциональными взаимозависимостями.
Пока система функционирует от точки старта до конечной точки, она рассматривается как работоспособная, даже после отказа отдельных её компонентов. Например, самолет, у которого два двигателя, может продолжать полет даже с одним исправным двигателем.
Давайте приступим к самому интересному — нарисуем схему какой-нибудь системы, очень примерную, просто блоками, один блок — один элемент:
Как думаете, какова вероятность того, что каждый блок в этой схеме будет доступен в любой момент времени?
Давайте посчитаем: возьмите значения надежности каждого и перемножьте их:
Надежность этой системы в любой момент времени составляет всего 43%, и вероятность сбоя в системе составляет 57%!
Очевидно, что “Сервис Г” снижает надежность нашей системы.
На диаграмме есть “запараллеленые” сервисы А и Б (сервис А резервирует сервис Б и наоборот). Такое резервирование может (но не всегда) значительно повысить надежность системы, у каждого из них надежность 99% и те же 99% — их “общая надежность”: (0,99 +0,99)/2 = 0,99.
Параллельное соединение указывает на избыточность или множественность путей выполнения чего-либо, а последовательное — говорит о том, что при выходе любого компонента из строя, сломается все остальное. Большинство систем — это просто последовательная цепочка сервисов.
Теперь, когда мы нарисовали примерную диаграмму нашего сервиса, можно начинать поиск данных, которые можно использовать для получения реальных значений для каждого блока. Обычно, в редкой организации они есть, чаще всего их нет. В любом случае, поиск таких данных — адски сложная задача.
На данный момент мы ищем только относительные и качественные значения. Нет необходимости слишком глубоко копаться в данных или проводить точный статистический анализ. Мы просто ищем очевидные слабые звенья в нашей цепочке и думаем, как эти звенья устранить или, хотя бы, усилить.
Если у вас есть только молоток, то все выглядит как гвоздь :) RBD можно использовать не только для систем или оборудования, точно так же можно разрисовать ваши процессы, и все остальное, что может быть представлено в виде наборов последовательных или параллельных связей. Задайте вероятность того, что каждый из них будет функционировать, и вы сможете быстро получить представление об общей эффективности и надежности системы.
Найдите слабое звено, выясните, почему оно слабое, как его можно усилить (да, придется потратить время и деньги) — и ваша система будет работать намного лучше.
И не забывайте, что стопроцентная надежность бессмысленна и вы никогда ее не добьетесь (про реальность добавления девяток к аптайму).
Результатами моделирования методом построения RBD для системы являются:
расчёты наработки на отказ (MTBF) всей системы в целом,
показатели доступности системы,
показатели надёжности системы,
оценки стоимости (эксплуатации, обслуживания…) системы,
возможность создания оптимальной модели обеспечения системы запасными компонентами.
Можно еще здесь подробнее почитать.
Или посмотреть:
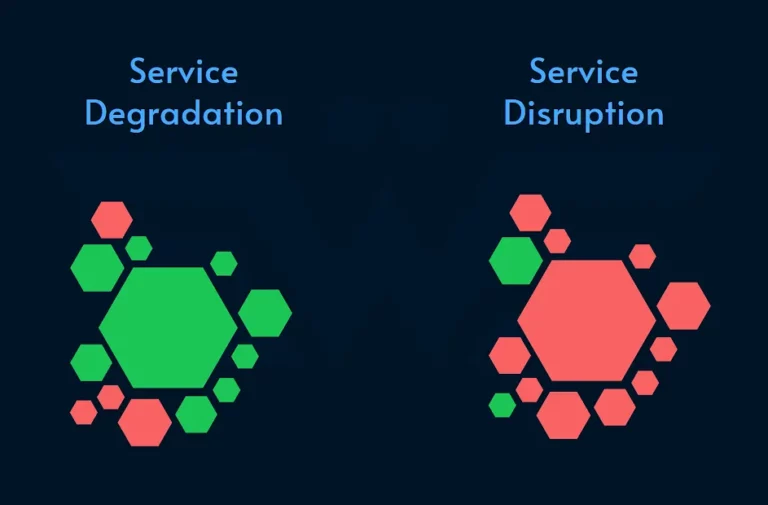
В чем разница между деградацией сервиса, перебоями в обслуживании и простоем сервиса и почему это имеет значение? Оригинал: Degradation vs disruption В контексте проектирования надежности есть три термина, которые связаны, но иногда используются неправильно. Грубо говоря: Ухудшение обслуживания (деградация сервиса) — это когда качество обслуживания падает. Если служба полностью останавливается, это перебои в работе службы. Если…
Оригинал: Great software design looks underwhelming by Sean Goedecke Несколько лет назад я потратил много времени на изучение проблем программирования. Сама задача была очень простой — создать CLI, который работал бы с API и позволял пользователю просматривать страницы и проверять данные. Мы допускали использование любых языков, и я видел самые разные варианты решений (если откровенно,…
(Это краткий трактат о природе аварий; как оцениваются аварии; как авария связана с непосредственной причиной; и вытекающее из этого новое понимание безопасности пациентов) Опасность — неотъемлемый атрибут сложных систем Все интересные системы (например, транспорт, здравоохранение, производство электроэнергии) изначально и неизбежно опасны по своей природе. Иногда можно изменить количество опасных факторов, но процессы, задействованные в системе,…
Если вы работаете с высоконагруженными системами или развиваете практику Site Reliability Engineering (SRE), то наверняка сталкивались с необходимостью быстро получить квалифицированный совет, провести аудит или спроектировать систему observability. Репозиторий philyuchkoff/sre-skills предлагает элегантное решение: превратить LLM-агента (вроде Claude Code) в опытного SRE-консультанта. Давайте разберем, что внутри и как этим пользоваться. 🎯 Основная идея Проект предоставляет набор…
Оригинал: Git’s Magic Files by Andrew Nesbitt. Продолжение моего поста о расширении функциональности Git. Git ищет в вашем репозитории несколько специальных файлов, которые управляют его поведением. Это не файлы конфигурации в .git/, а зафиксированные файлы, которые перемещаются вместе с вашим кодом и влияют на то, как Git обрабатывает ваши файлы. Если вы разрабатываете инструмент для…
Где поставим запятую? 🙂 или Как не дать автономному агенту положить прод и при этом не отстать от жизни Последние полгода мои коллеги (и не только коллеги) разделились на два лагеря. Одни с ужасом рассказывают, как их AI-SRE-агент случайно положил базу данных, потому что «просто хотел помочь с таймаутами». Другие восторженно показывают дашборды, где инциденты…